Jede GPU im Blick. Jeder Knoten erreichbar.
PeakNode überwacht GPU-Server, Workstations und DGX-Systeme: Auslastung, Speicher, Temperatur und Leistung je Karte, dazu Erreichbarkeit, Heartbeats und Statusseiten. Alarm, bevor ein Training steht oder ein Gerät still ausfällt.
GPU nodes
3 nodes · 10 GPUs · last reported valuesDie GPU-Nodes-Übersicht des Portals mit aufgezeichneten Messwerten dreier Testknoten vom 8. Oktober 2026, im selben Moment mit nvidia-smi gegengeprüft. Keine Simulation.
Gebaut für die Systeme, die Sie betreiben
Vom einzelnen DGX Spark bis zum 8-GPU-Knoten mit NVLink. Ein Agent, ein Portal, die gleichen Zahlen wie auf dem Gerät.
Managed Monitoring Service für Ihre Kunden
Ihre Kunden betreiben GPU-Server, Workstations und DGX-Systeme, die Überwachung übernehmen Sie. Alle Kunden in einem Portal, Alarme in Ihrem Ticket-System, und bei einem Fehler liegen die Daten für die Diagnose bereits vor.
Mehr für Systemhäuser Kontakt aufnehmenMehrere Kunden, ein Portal
Projekte gliedern die Monitore nach Kunde. Oder je Kunde ein eigenes Konto, in das Sie als Teammitglied wechseln.
Diagnose statt Vermutung
Xid-Meldungen, ECC, Drosselgrund, fehlende GPU und Verlauf je Karte zeigen, ob Hardware, Treiber, Kühlung oder ein Job die Ursache ist.
Alarme in Ihr Ticket-System
Webhook, Microsoft Teams, Slack oder E-Mail, je Monitor einstellbar. Auch gleichzeitig an Sie und die IT des Kunden.
Statusseite je Kunde
Uptime der letzten 90 Tage und Vorfälle, mit Logo, eigener Domain und Passwortschutz. Der sichtbare Nachweis Ihrer Leistung.
Keine Schätzwerte. Keine Platzhalter.
Der Agent liest direkt aus dem NVIDIA-Treiber und dem Linux-Kernel. Was eine Quelle nicht liefert, zeigt das Portal als „-" statt als Null. Jede Formel haben wir gegen das Gerät geprüft, auf RTX PRO 6000 Blackwell, 8× H100 SXM und B300 mit MIG.
Offline-Erkennung
Drei Intervalle ohne Meldung lösen den Alarm aus, die Rückmeldung kommt automatisch.
Schwellwert-Alarme
GPU-Temperatur, Auslastung, Speicher, Leerlauf-Dauer, CPU, RAM, Swap, Festplatte. Wahlweise erst nach mehreren Messungen.
Ein Token je Gerät
Jeder Server-Monitor hat sein eigenes Zugangstoken, gesendet im Authorization-Header. Verbindung nur vom Gerät zum Portal.
Container-tauglich
In Docker und Kubernetes meldet der Agent die zugeteilten Grenzen, nicht den Wirt. cgroup v1 und v2.
Das, was ein Training wirklich stoppt.
Auslastung in Prozent sagt nur, dass ein Kernel lief. PeakNode liest zusätzlich das Kernel-Log und die Fehlerzähler des Treibers und ordnet jedes Ereignis der Karte zu, nach Schweregrad, mit Benachrichtigung.
| Zeitpunkt | Schweregrad | Ereignis |
|---|---|---|
| 08.10.2026 16:54 | Kritisch | GPU 0: Xid 79 (GPU has fallen off the bus) |
| 08.10.2026 16:54 | Kritisch | Weniger GPUs als erwartet (7 / 8) |
| 08.10.2026 16:54 | Kritisch | GPU 1: Neue unkorrigierbare ECC-Fehler (+2 / 2) |
| 08.10.2026 16:54 | Warnung | GPU 1: Thermische Drosselung (hw_thermal, sw_power_cap, 84 °C) |
| 08.10.2026 16:51 | Hinweis | GPU 1: Xid 31 (GPU memory page fault): pid=4242, name=python3 |
Beispielereignisse aus dem Funktionstest des Portals, in der Darstellung des Portals. Echte Xid-Ereignisse folgen mit der nächsten Hardware-Testreihe.
Monitoring, das keine Angriffsfläche hinzufügt
Der Agent öffnet keinen Port und nimmt keine Befehle entgegen. Das Portal ist nach einem Audit des gesamten Quellcodes gehärtet, die Maßnahmen stehen offen auf der Sicherheitsseite.
Nur ausgehend
Cron-Skript ohne Daemon, Port 443 nach außen, TLS geprüft. Eingehend wird nichts geöffnet.
Konto-Schutz
Zwei-Faktor-Authentifizierung, Sperre je IP und Konto nach Fehlversuchen, Reset-Links verfallen nach 60 Minuten.
Keine Umwege ins Innere
Uptime-Checks, Tools und Webhooks akzeptieren nur öffentliche Ziele. Private Netze und Metadaten-Adressen werden abgewiesen.
Zuverlässig im Fehlerfall
Timeouts gegen hängende Treiber, Offline-Erkennung nach drei Intervallen, deduplizierte Ereignisse, letzte bekannte Werte statt Nullen.
Sehen, wer auf Ihre GPU-Server zugreift.
PeakNode zeigt, ob Ihre Server laufen. NodeGuard zeigt, wer sich anmeldet, welche Ports offen sind, ob Systemdateien geändert wurden und wer auf den GPUs rechnet - und meldet es in Ihren Benachrichtigungskanälen.
- SSH-AnmeldungenFehlversuche, häufigste Absender, jede Anmeldung von einer neuen Adresse.
- Nutzer auf den GPUsWer rechnet auf Ihren Karten - mit Hinweis bei Prozessnamen bekannter Mining-Software.
- Offene PortsNeue Ports an nicht lokalen Schnittstellen, mit Prozess.
- SystemdateienPrüfsummen von Benutzerliste, sudoers, SSH-Konfiguration und den Schlüsseln von root.
- SicherheitsupdatesOffene Updates und ausstehender Neustart (Debian und Ubuntu).
einzeln buchbar, monatlich kündbar
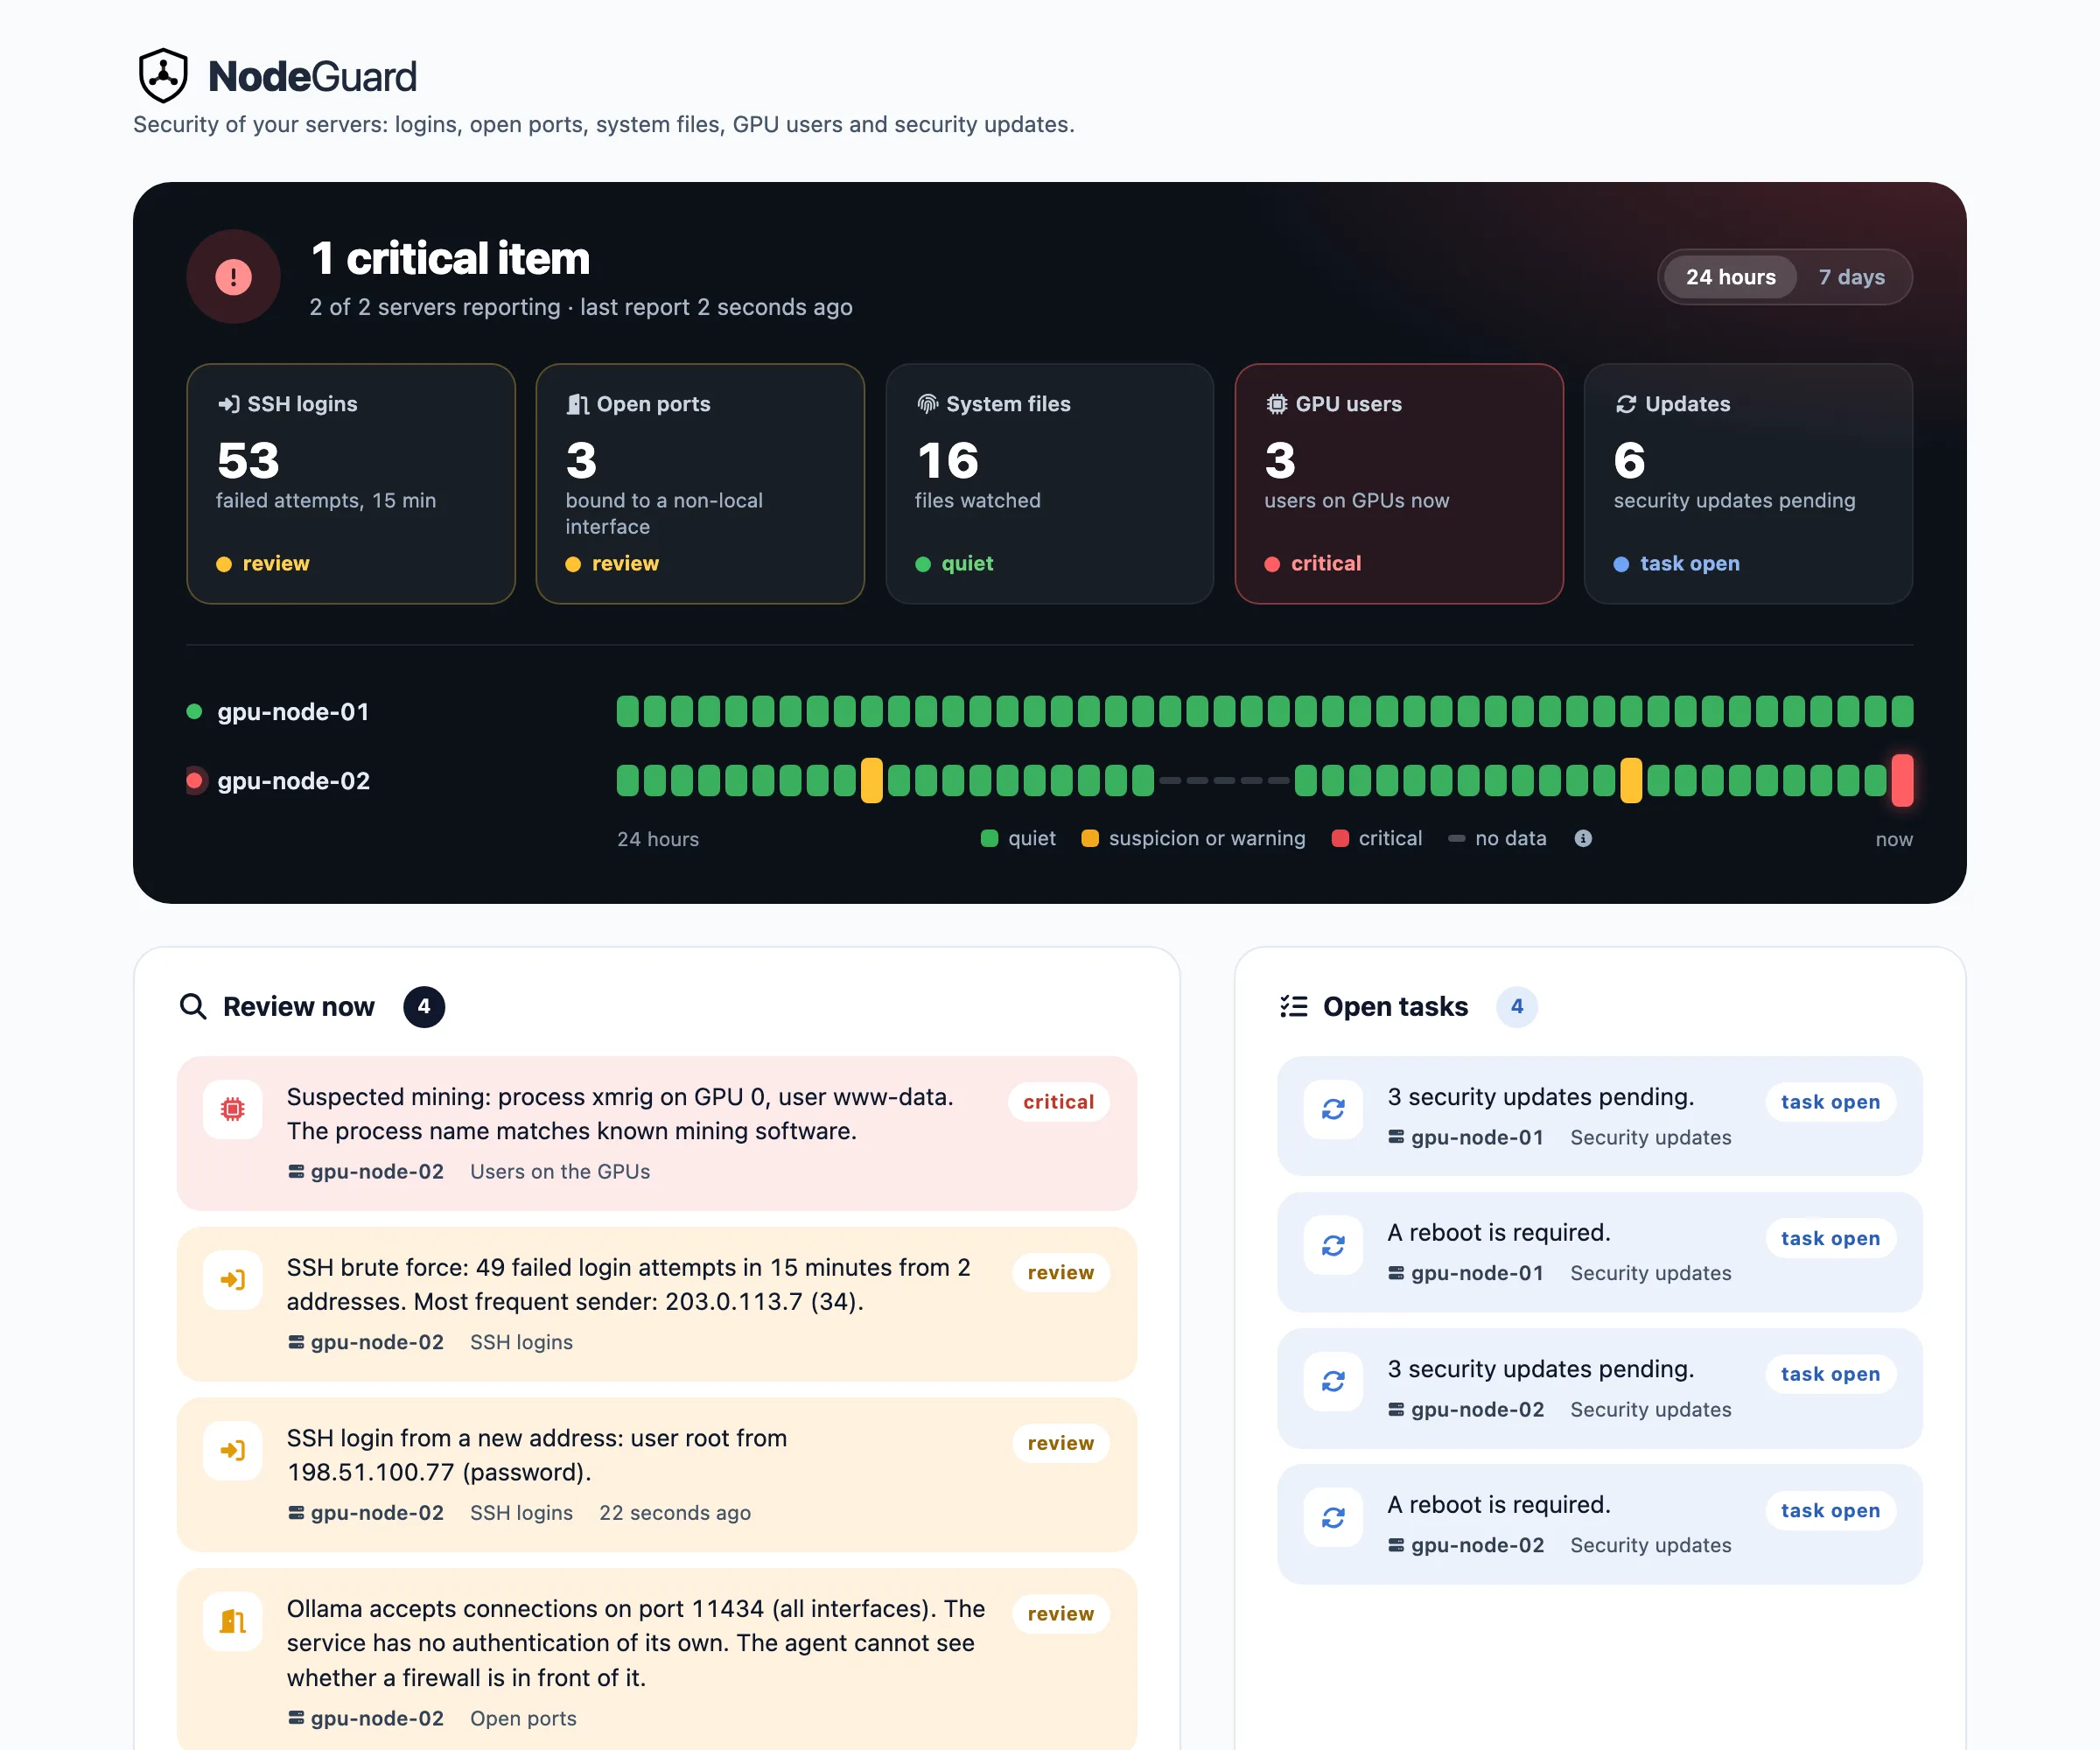
Aufnahme des NodeGuard-Dashboards mit Demo-Daten. Namen und Adressen sind Platzhalter.
Get notified with ease
Countless notification integrations for all your needs.
Developer ready
Fully featured & easy to use API system for developers.
--url 'https://peaknode.de/api/monitors' \
--header 'Authorization: Bearer {api_key}' \
--header 'Content-Type: multipart/form-data' \
--form 'name=Example' \
--form 'target=https://example.com/' \
Simple, transparent pricing.
Proof of Concept
-
3 server monitors
-
5 heartbeats
-
5 monitors
-
2 Ping locations
-
5 DNS monitors
-
5 domain names
-
1 status pages
-
Included analytics
-
3 projects
-
0 teams
-
Notification handlers
-
Email reports
-
14 days data retention
-
API access
-
Removable branding
-
Search engine indexing
-
2 export features
-
Password protection
-
Custom back-half URL
-
Custom CSS
-
Custom JS
-
Custom PWA app
-
14 days status pages statistics retention
-
No ads
Premium Lizenz
-
10 server monitors
-
50 heartbeats
-
50 monitors
-
2 Ping locations
-
25 DNS monitors
-
25 domain names
-
5 status pages
-
Included analytics
-
Unlimited projects
-
1 teams
-
Notification handlers
-
Email reports
-
1 year data retention
-
API access
-
Removable branding
-
Search engine indexing
-
3 export features
-
Password protection
-
Custom back-half URL
-
Custom CSS
-
Custom JS
-
Custom PWA app
-
1 year status pages statistics retention
-
No ads
Enterprise Lizenz
-
50 server monitors
-
250 heartbeats
-
250 monitors
-
2 Ping locations
-
100 DNS monitors
-
100 domain names
-
25 status pages
-
Included analytics
-
Unlimited projects
-
Unlimited teams
-
Notification handlers
-
Email reports
-
1 year data retention
-
API access
-
Removable branding
-
Search engine indexing
-
3 export features
-
Password protection
-
Custom back-half URL
-
Custom CSS
-
Custom JS
-
Custom PWA app
-
1 year status pages statistics retention
-
No ads
On-Premise
-
All data stays in your network
-
Monitors internal hosts and private networks
-
No limits on monitors, GPUs, users or retention
-
Installer, documentation and remote setup session
-
Updates as a package, applied in one step
-
Readable source code, auditable agent
Answer for your common question
Get started
Track the uptime of your servers & display their stats on a status page.