Monat, freier Zeitraum oder ein Projekt
Vorgabe ist der Vormonat. Wählbar sind die Monate, für die noch Messdaten vorliegen, oder ein freier Zeitraum von höchstens 366 Tagen. Auf ein Projekt begrenzt, entsteht je Kunde ein eigener Bericht.
Neu: Temperatur, Lüfter, Netzteile und SSD-Zustand je Server. Hardware-Gesundheit ansehen
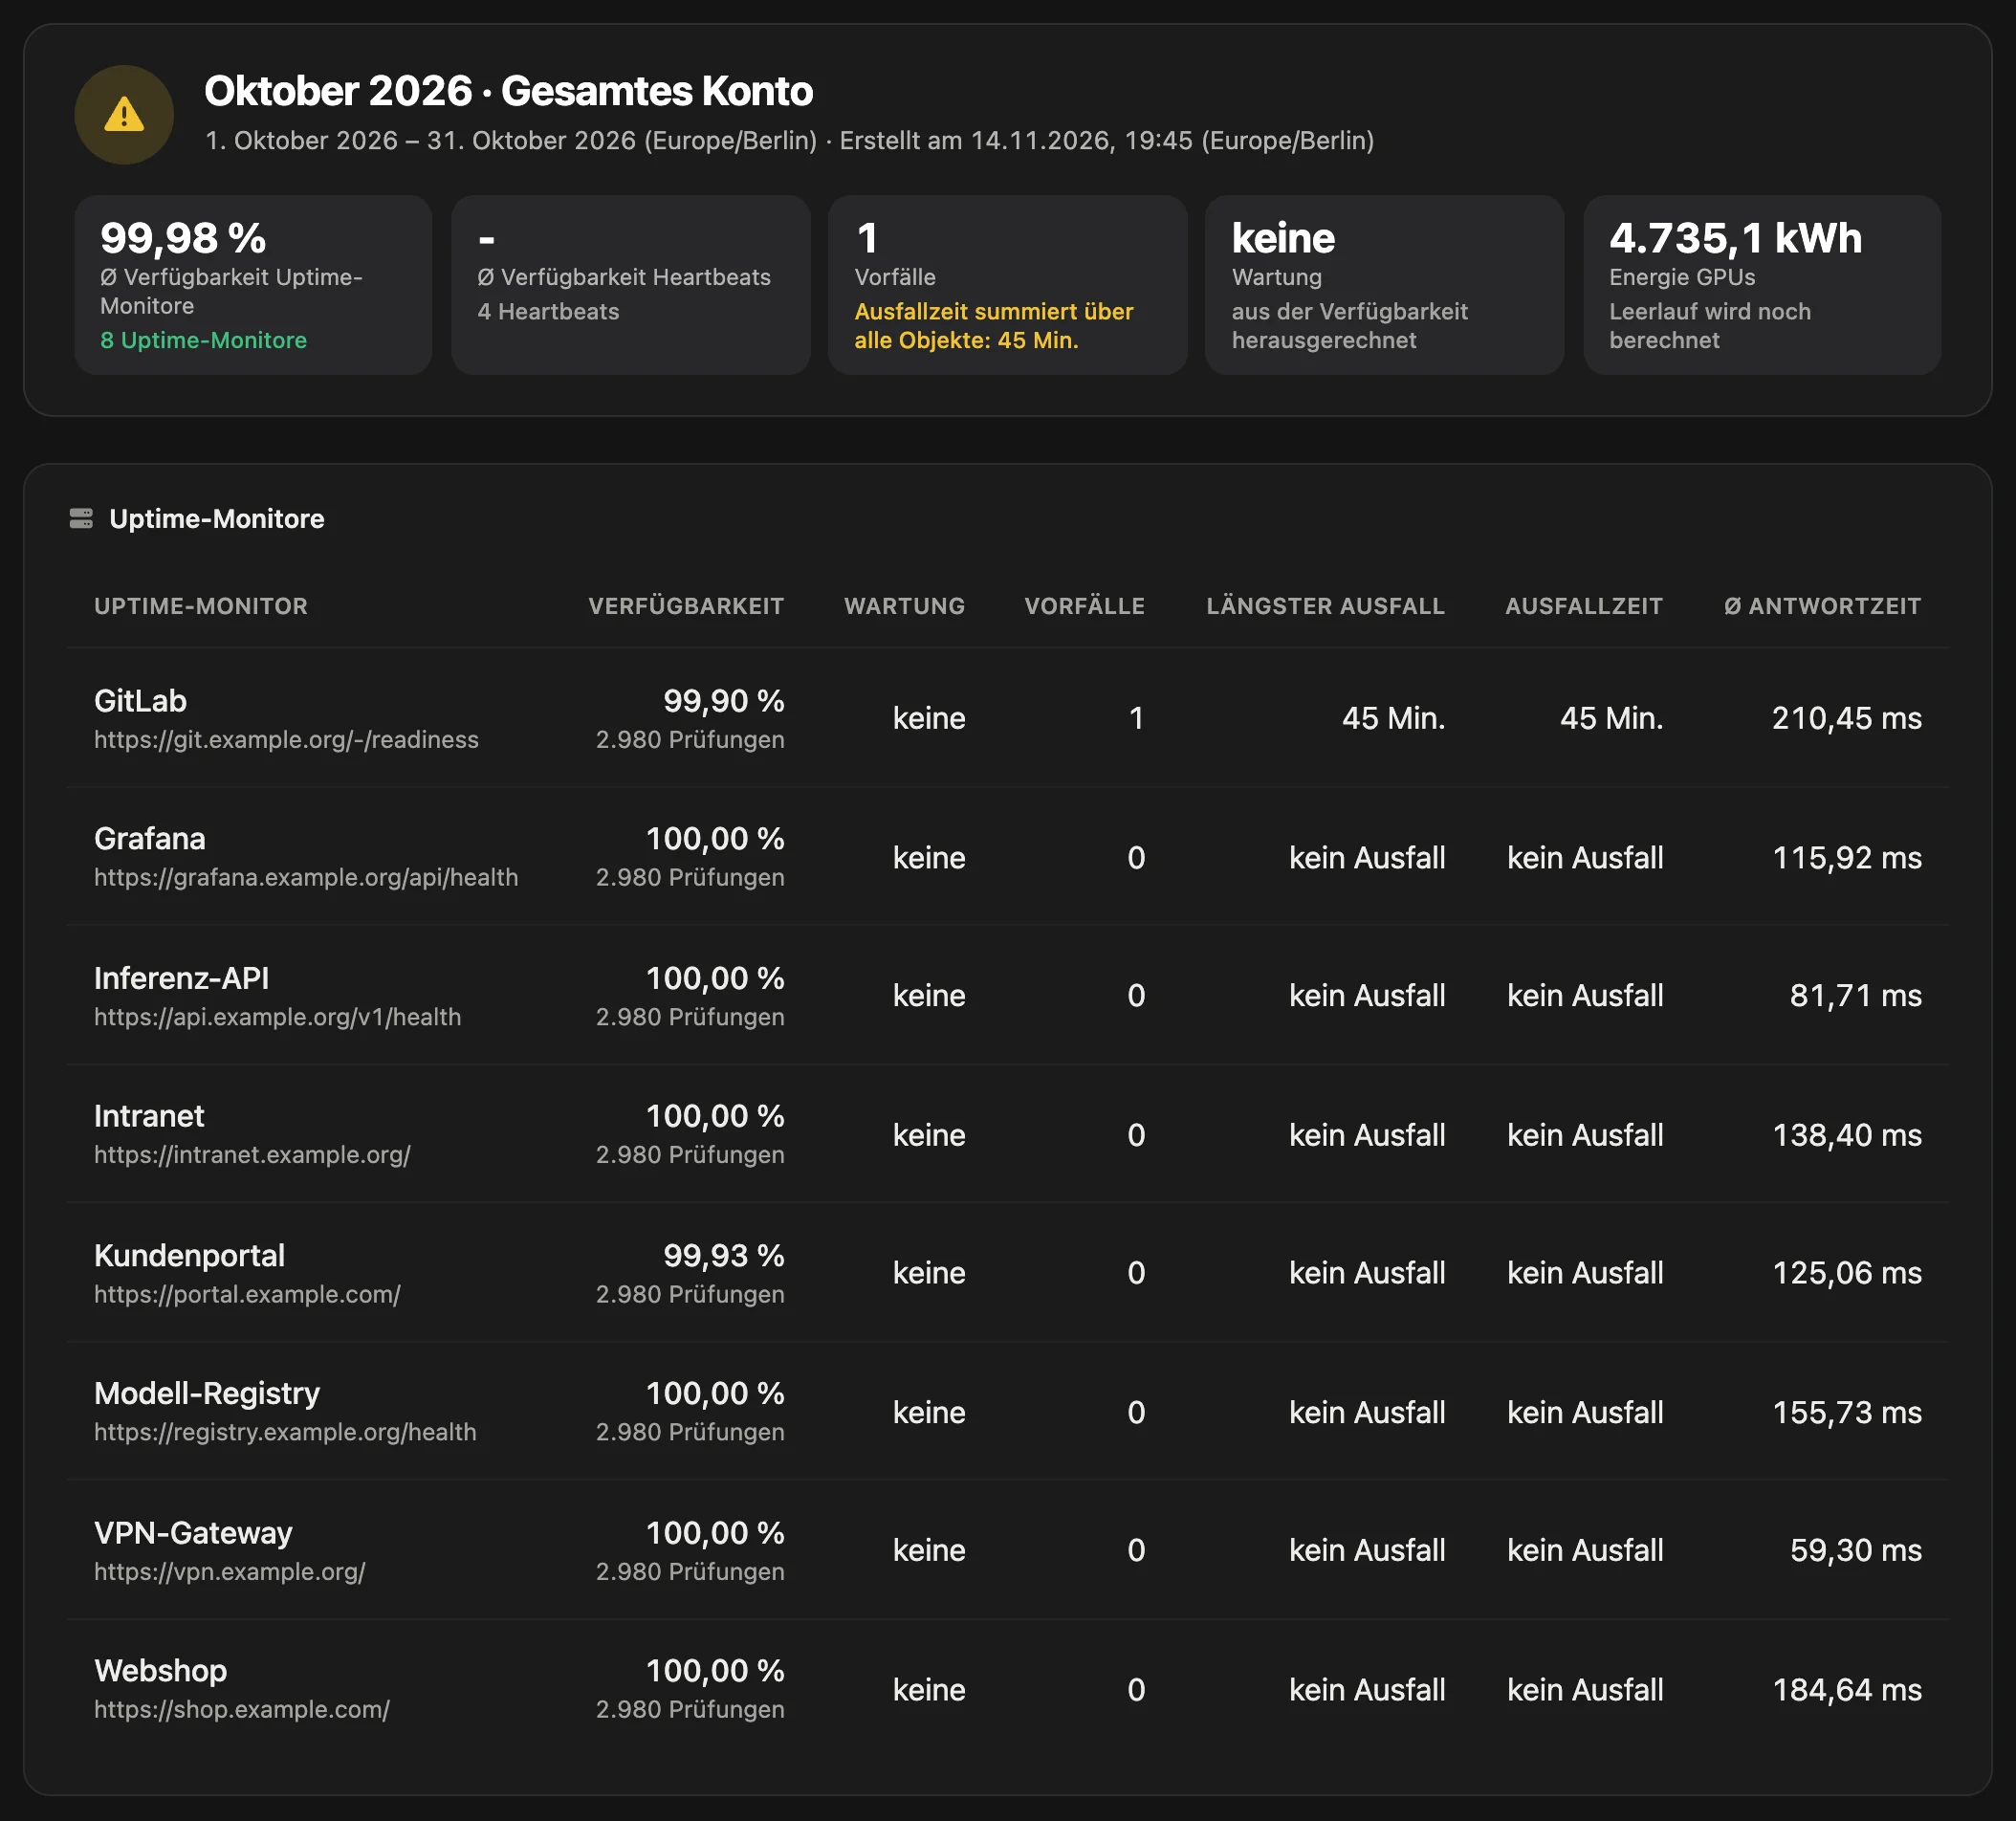
Am Monatsende will jemand wissen, wie oft etwas ausgefallen ist und wie lange. Der Bericht von PeakNode beantwortet das für Ihre Dienste und Server: Verfügbarkeit, Vorfälle mit Beginn und Dauer, Ausfallzeit. Sie erhalten ihn als Vorschau im Portal und als PDF, auf Wunsch am 1. des Monats per E-Mail.
Aufnahme aus dem Portal mit Beispieldaten.
Der SLA- und Monatsbericht von PeakNode fasst für einen Kalendermonat oder einen freien Zeitraum bis 366 Tage zusammen: Verfügbarkeit je Uptime-Monitor (von außen geprüfter Dienst) und Heartbeat (Lebenszeichen eines Jobs), Vorfälle mit Ausfallzeit, CPU- und GPU-Auslastung der Server, GPU-Energie, Leerlauf und Leerlaufkosten, anstehende SSL- und Domain-Abläufe und die Wartungszeiten. Es gibt ihn als Vorschau im Portal und als PDF, auf Wunsch am 1. des Monats per E-Mail.
Ein Bericht je Konto oder je Projekt. Er rechnet nichts schön und erklärt am Ende, wie jede Zahl entsteht.
Vorgabe ist der Vormonat. Wählbar sind die Monate, für die noch Messdaten vorliegen, oder ein freier Zeitraum von höchstens 366 Tagen. Auf ein Projekt begrenzt, entsteht je Kunde ein eigener Bericht.
Verfügbarkeit heißt: erfolgreiche Prüfungen geteilt durch alle Prüfungen im Zeitraum, bei Heartbeats pünktliche Läufe geteilt durch alle. Während einer Wartung wird nicht geprüft, die Wartungszeit ist damit herausgerechnet und steht in einer eigenen Spalte.
Aufgeführt sind alle Vorfälle, die den Zeitraum berühren, bis zu 500 in der Liste. Ausfallzeit und längster Ausfall zählen nur die Zeit innerhalb des Zeitraums. Beginnt ein Vorfall im Vormonat, zeigt die Liste die volle Dauer und daneben „davon im Zeitraum“.
Je Server-Monitor stehen Mittel und Spitze der CPU- und der GPU-Auslastung, die Energie der GPUs in kWh und der Leerlauf in GPU-Stunden. Mit hinterlegten Kosten je GPU-Stunde kommt der Betrag für den Leerlauf dazu. Die Energie ist die der GPUs, nicht die des ganzen Servers.
Die Vorschau zeigt den Bericht im Portal, „PDF herunterladen“ erzeugt ein A4-Dokument mit Seitenzahlen. Das PDF setzt den PDF-Export Ihres Tarifs voraus. Adressen von Monitoren und Servern erscheinen ohne eingebettete Zugangsdaten.
Auf Wunsch geht der Bericht des Vormonats am 1. ab 06:00 Uhr Ihrer Zeitzone als PDF hinaus, an die Adresse des Kontos und an eigene, bestätigte E-Mail-Kanäle, höchstens 10 Empfänger. Der Versand braucht den PDF-Export des Tarifs und lässt sich auf ein Projekt beschränken.
| Uptime-Monitor | Verfügbarkeit | Wartung | Vorfälle | Längster Ausfall | Ausfallzeit | Ø Antwortzeit |
|---|---|---|---|---|---|---|
| Inferenz-API | 99,95 % | 2 Std. | 1 | 21 Min. | 21 Min. | 184 ms |
| Portal-Login | 100 % | 2 Std. | 0 | kein Ausfall | kein Ausfall | 96 ms |
| Neuer Dienst | - (keine Prüfung im Zeitraum) | keine | - | - | - | - |
Spalten wie im Bericht. Ein Monitor ohne Prüfung im Zeitraum zeigt „-“ und nicht „kein Ausfall“.
| Abschnitt | Inhalt | Grundlage |
|---|---|---|
| Zusammenfassung | Ø Verfügbarkeit der Uptime-Monitore und der Heartbeats, Zahl der Vorfälle mit summierter Ausfallzeit, Wartung, Energie der GPUs, Leerlauf | Mittel bzw. Summe der einzelnen Objekte |
| Uptime-Monitore | Verfügbarkeit, Wartung, Vorfälle, längster Ausfall, Ausfallzeit, Ø Antwortzeit | gespeicherte Prüfungen, Antwortzeit nur aus erfolgreichen |
| Heartbeats | Verfügbarkeit, Wartung, Vorfälle, längster Ausfall, Ausfallzeit | pünktliche Läufe geteilt durch alle Läufe |
| Vorfälle | Uptime-Monitor oder Heartbeat, Beginn, Ende, Dauer, davon im Zeitraum | Vorfälle, die den Zeitraum berühren, höchstens 500 Zeilen |
| Server und GPU-Nodes | CPU-Auslastung Ø und Spitze, GPU-Auslastung Ø und Spitze, Energie GPUs, Leerlauf GPUs, Agent-Berichte | gespeicherte Berichte des Agenten, Leerlauf unter 5 % Auslastung |
| SSL- und Domain-Abläufe im Folgemonat | Domain-Name, Art (SSL-Zertifikat oder Domain-Registrierung), Ablauf | gespeicherte Ablaufdaten nach dem Stand der letzten Prüfung |
| Wartungsfenster | Wartungsfenster, Beginn, Ende, Dauer, betroffene Objekte | tatsächlich wirksame Wartungszeiträume, nicht die Planung |
| Erläuterungen | Rechenweg für Verfügbarkeit, Vorfälle, Server-Werte und Abläufe, Zeitzone, Hinweis „Messdaten ab ...“ | fester Text des Berichts |
Nicht im Bericht stehen Hardware-Ereignisse wie Xid oder ECC, die Hinweise von NodeCare und die Ereignisse von NodeGuard. Der Bericht nennt die gemessene Verfügbarkeit und vergleicht sie nicht mit einem vertraglich vereinbarten Zielwert. Die Ausfallzeit in der Zusammenfassung ist die Summe über alle Objekte und kann deshalb länger sein als der Zeitraum.
Der Bericht braucht keine eigene Einrichtung. Er liest, was Ihre Monitore ohnehin aufzeichnen.
Im Portal „Berichte“ öffnen, Monat oder freien Zeitraum wählen und bei Bedarf ein Projekt. Mit „Anzeigen“ erscheint die Vorschau.
Mit „PDF herunterladen“ erhalten Sie den Bericht als Datei. Teammitglieder sehen Vorschau und PDF ebenfalls.
Unter „Automatischer Versand“ die Empfänger wählen. Weitere Adressen legen Sie als E-Mail-Kanal an, sie werden vor dem ersten Versand bestätigt. Den Versand stellt der Inhaber des Kontos ein, rückwirkend geht nichts hinaus.
Weiter zu:
Verfügbarkeit, Vorfälle, längster Ausfall, Ausfallzeit und mittlere Antwortzeit je Uptime-Monitor, dasselbe ohne Antwortzeit je Heartbeat. Dazu CPU- und GPU-Auslastung, GPU-Energie und Leerlauf je Server, die SSL- und Domain-Abläufe des Folgemonats und die Wartungszeiten.
Als Anteil der erfolgreichen Prüfungen an allen Prüfungen im Zeitraum, bei Heartbeats als Anteil der pünktlichen Läufe. Es ist dieselbe Rechnung wie im Portal und auf der Statusseite.
Nein. Während eines Wartungsfensters wird nicht geprüft, deshalb gehen diese Zeiten nicht in die Verfügbarkeit ein. Der Bericht weist die Wartungszeit je Monitor in einer eigenen Spalte aus.
Für jeden Kalendermonat, für den noch Messdaten vorliegen, oder für einen freien Zeitraum von höchstens 366 Tagen. Wie weit die Daten zurückreichen, bestimmt die Vorhaltezeit des Tarifs: 14 Tage im Proof of Concept, ein Jahr in Premium und Enterprise.
Ja, über Projekte. Liegen die Monitore eines Kunden in einem Projekt, begrenzen Sie den Bericht auf dieses Projekt. Wie Systemhäuser PeakNode für mehrere Kunden einsetzen, steht auf der Seite Für Systemhäuser.
Weil Ihr Tarif Prüfungen, Heartbeat-Läufe und Server-Berichte nur für die Vorhaltezeit speichert und ältere löscht. Reicht ein Zeitraum weiter zurück, beginnen alle Werte des Berichts an diesem Datum, auch Vorfälle, Ausfallzeit und Wartung.
Ein SLA (Service Level Agreement) ist eine Vereinbarung über die Qualität eines Dienstes, etwa eine zugesagte Verfügbarkeit im Monat und Reaktionszeiten. Der SLA-Bericht von PeakNode liefert dafür die gemessenen Werte: Verfügbarkeit, Vorfälle und Ausfallzeit je Monitor. Ob ein Wert die Vereinbarung erfüllt, bewerten Sie selbst.
Rund 43 Minuten in einem Monat mit 30 Tagen und knapp 8 Stunden 46 Minuten im Jahr. Bei 99,99 % sind es etwa 4 Minuten im Monat, bei 99,5 % rund 3 Stunden 36 Minuten. Der Bericht von PeakNode weist die gemessene Ausfallzeit je Monitor aus, Wartungszeiten getrennt, siehe Uptime-Monitoring.
Konto anlegen, Monitore einrichten, unter „Berichte“ den Zeitraum wählen. Der Tarif Proof of Concept ist kostenlos.