Jede GPU im Blick. Jeder Knoten erreichbar.
PeakNode überwacht GPU-Server, Workstations und DGX-Systeme: Auslastung, Speicher, Temperatur und Leistung je Karte, dazu Erreichbarkeit, Heartbeats und Statusseiten. Alarm, bevor ein Training steht oder ein Gerät still ausfällt.
GPU-Nodes
3 Knoten · 10 GPUs · zuletzt gemeldete WerteDie GPU-Nodes-Übersicht des Portals mit aufgezeichneten Messwerten dreier Testknoten vom 8. Oktober 2026, im selben Moment mit nvidia-smi gegengeprüft. Keine Simulation.
Gebaut für die Systeme, die Sie betreiben
Vom einzelnen DGX Spark bis zum 8-GPU-Knoten mit NVLink. Ein Agent, ein Portal, die gleichen Zahlen wie auf dem Gerät.
Managed Monitoring Service für Ihre Kunden
Ihre Kunden betreiben GPU-Server, Workstations und DGX-Systeme, die Überwachung übernehmen Sie. Alle Kunden in einem Portal, Alarme in Ihrem Ticket-System, und bei einem Fehler liegen die Daten für die Diagnose bereits vor.
Mehr für Systemhäuser Kontakt aufnehmenMehrere Kunden, ein Portal
Projekte gliedern die Monitore nach Kunde. Oder je Kunde ein eigenes Konto, in das Sie als Teammitglied wechseln.
Diagnose statt Vermutung
Xid-Meldungen, ECC, Drosselgrund, fehlende GPU und Verlauf je Karte zeigen, ob Hardware, Treiber, Kühlung oder ein Job die Ursache ist.
Alarme in Ihr Ticket-System
Webhook, Microsoft Teams, Slack oder E-Mail, je Monitor einstellbar. Auch gleichzeitig an Sie und die IT des Kunden.
Statusseite je Kunde
Uptime der letzten 90 Tage und Vorfälle, mit Logo, eigener Domain und Passwortschutz. Der sichtbare Nachweis Ihrer Leistung.
Keine Schätzwerte. Keine Platzhalter.
Der Agent liest direkt aus dem NVIDIA-Treiber und dem Linux-Kernel. Was eine Quelle nicht liefert, zeigt das Portal als „-" statt als Null. Jede Formel haben wir gegen das Gerät geprüft, auf RTX PRO 6000 Blackwell, 8× H100 SXM und B300 mit MIG.
Offline-Erkennung
Drei Intervalle ohne Meldung lösen den Alarm aus, die Rückmeldung kommt automatisch.
Schwellwert-Alarme
GPU-Temperatur, Auslastung, Speicher, Leerlauf-Dauer, CPU, RAM, Swap, Festplatte. Wahlweise erst nach mehreren Messungen.
Ein Token je Gerät
Jeder Server-Monitor hat sein eigenes Zugangstoken, gesendet im Authorization-Header. Verbindung nur vom Gerät zum Portal.
Container-tauglich
In Docker und Kubernetes meldet der Agent die zugeteilten Grenzen, nicht den Wirt. cgroup v1 und v2.
Das, was ein Training wirklich stoppt.
Auslastung in Prozent sagt nur, dass ein Kernel lief. PeakNode liest zusätzlich das Kernel-Log und die Fehlerzähler des Treibers und ordnet jedes Ereignis der Karte zu, nach Schweregrad, mit Benachrichtigung.
| Zeitpunkt | Schweregrad | Ereignis |
|---|---|---|
| 08.10.2026 16:54 | Kritisch | GPU 0: Xid 79 (GPU has fallen off the bus) |
| 08.10.2026 16:54 | Kritisch | Weniger GPUs als erwartet (7 / 8) |
| 08.10.2026 16:54 | Kritisch | GPU 1: Neue unkorrigierbare ECC-Fehler (+2 / 2) |
| 08.10.2026 16:54 | Warnung | GPU 1: Thermische Drosselung (hw_thermal, sw_power_cap, 84 °C) |
| 08.10.2026 16:51 | Hinweis | GPU 1: Xid 31 (GPU memory page fault): pid=4242, name=python3 |
Beispielereignisse aus dem Funktionstest des Portals, in der Darstellung des Portals. Echte Xid-Ereignisse folgen mit der nächsten Hardware-Testreihe.
Monitoring, das keine Angriffsfläche hinzufügt
Der Agent öffnet keinen Port und nimmt keine Befehle entgegen. Das Portal ist nach einem Audit des gesamten Quellcodes gehärtet, die Maßnahmen stehen offen auf der Sicherheitsseite.
Nur ausgehend
Cron-Skript ohne Daemon, Port 443 nach außen, TLS geprüft. Eingehend wird nichts geöffnet.
Konto-Schutz
Zwei-Faktor-Authentifizierung, Sperre je IP und Konto nach Fehlversuchen, Reset-Links verfallen nach 60 Minuten.
Keine Umwege ins Innere
Uptime-Checks, Tools und Webhooks akzeptieren nur öffentliche Ziele. Private Netze und Metadaten-Adressen werden abgewiesen.
Zuverlässig im Fehlerfall
Timeouts gegen hängende Treiber, Offline-Erkennung nach drei Intervallen, deduplizierte Ereignisse, letzte bekannte Werte statt Nullen.
Sehen, wer auf Ihre GPU-Server zugreift.
PeakNode zeigt, ob Ihre Server laufen. NodeGuard zeigt, wer sich anmeldet, welche Ports offen sind, ob Systemdateien geändert wurden und wer auf den GPUs rechnet - und meldet es in Ihren Benachrichtigungskanälen.
- SSH-AnmeldungenFehlversuche, häufigste Absender, jede Anmeldung von einer neuen Adresse.
- Nutzer auf den GPUsWer rechnet auf Ihren Karten - mit Hinweis bei Prozessnamen bekannter Mining-Software.
- Offene PortsNeue Ports an nicht lokalen Schnittstellen, mit Prozess.
- SystemdateienPrüfsummen von Benutzerliste, sudoers, SSH-Konfiguration und den Schlüsseln von root.
- SicherheitsupdatesOffene Updates und ausstehender Neustart (Debian und Ubuntu).
- Software-StandWelche Software in welcher Version läuft - abgeglichen mit den aktuellen Patch-Versionen, dem Support-Ende je Zweig und einer gepflegten Liste kritischer Sicherheitshinweise.
- Schwachstellen-AbgleichAlle installierten Pakete gegen die öffentliche Schwachstellendatenbank OSV.dev und die CISA-Liste nachweislich ausgenutzter Lücken - bei jeder Paketänderung und alle sechs Stunden, mit der Paketversion, die die Lücke schließt.
- AnomalieerkennungLernt das übliche Verhalten von GPU-Last, GPU-Leistung, CPU und Netzwerk nach Tageszeit und meldet deutliche Abweichungen, zum Beispiel Rechenlast um drei Uhr nachts.
einzeln buchbar, monatlich kündbar
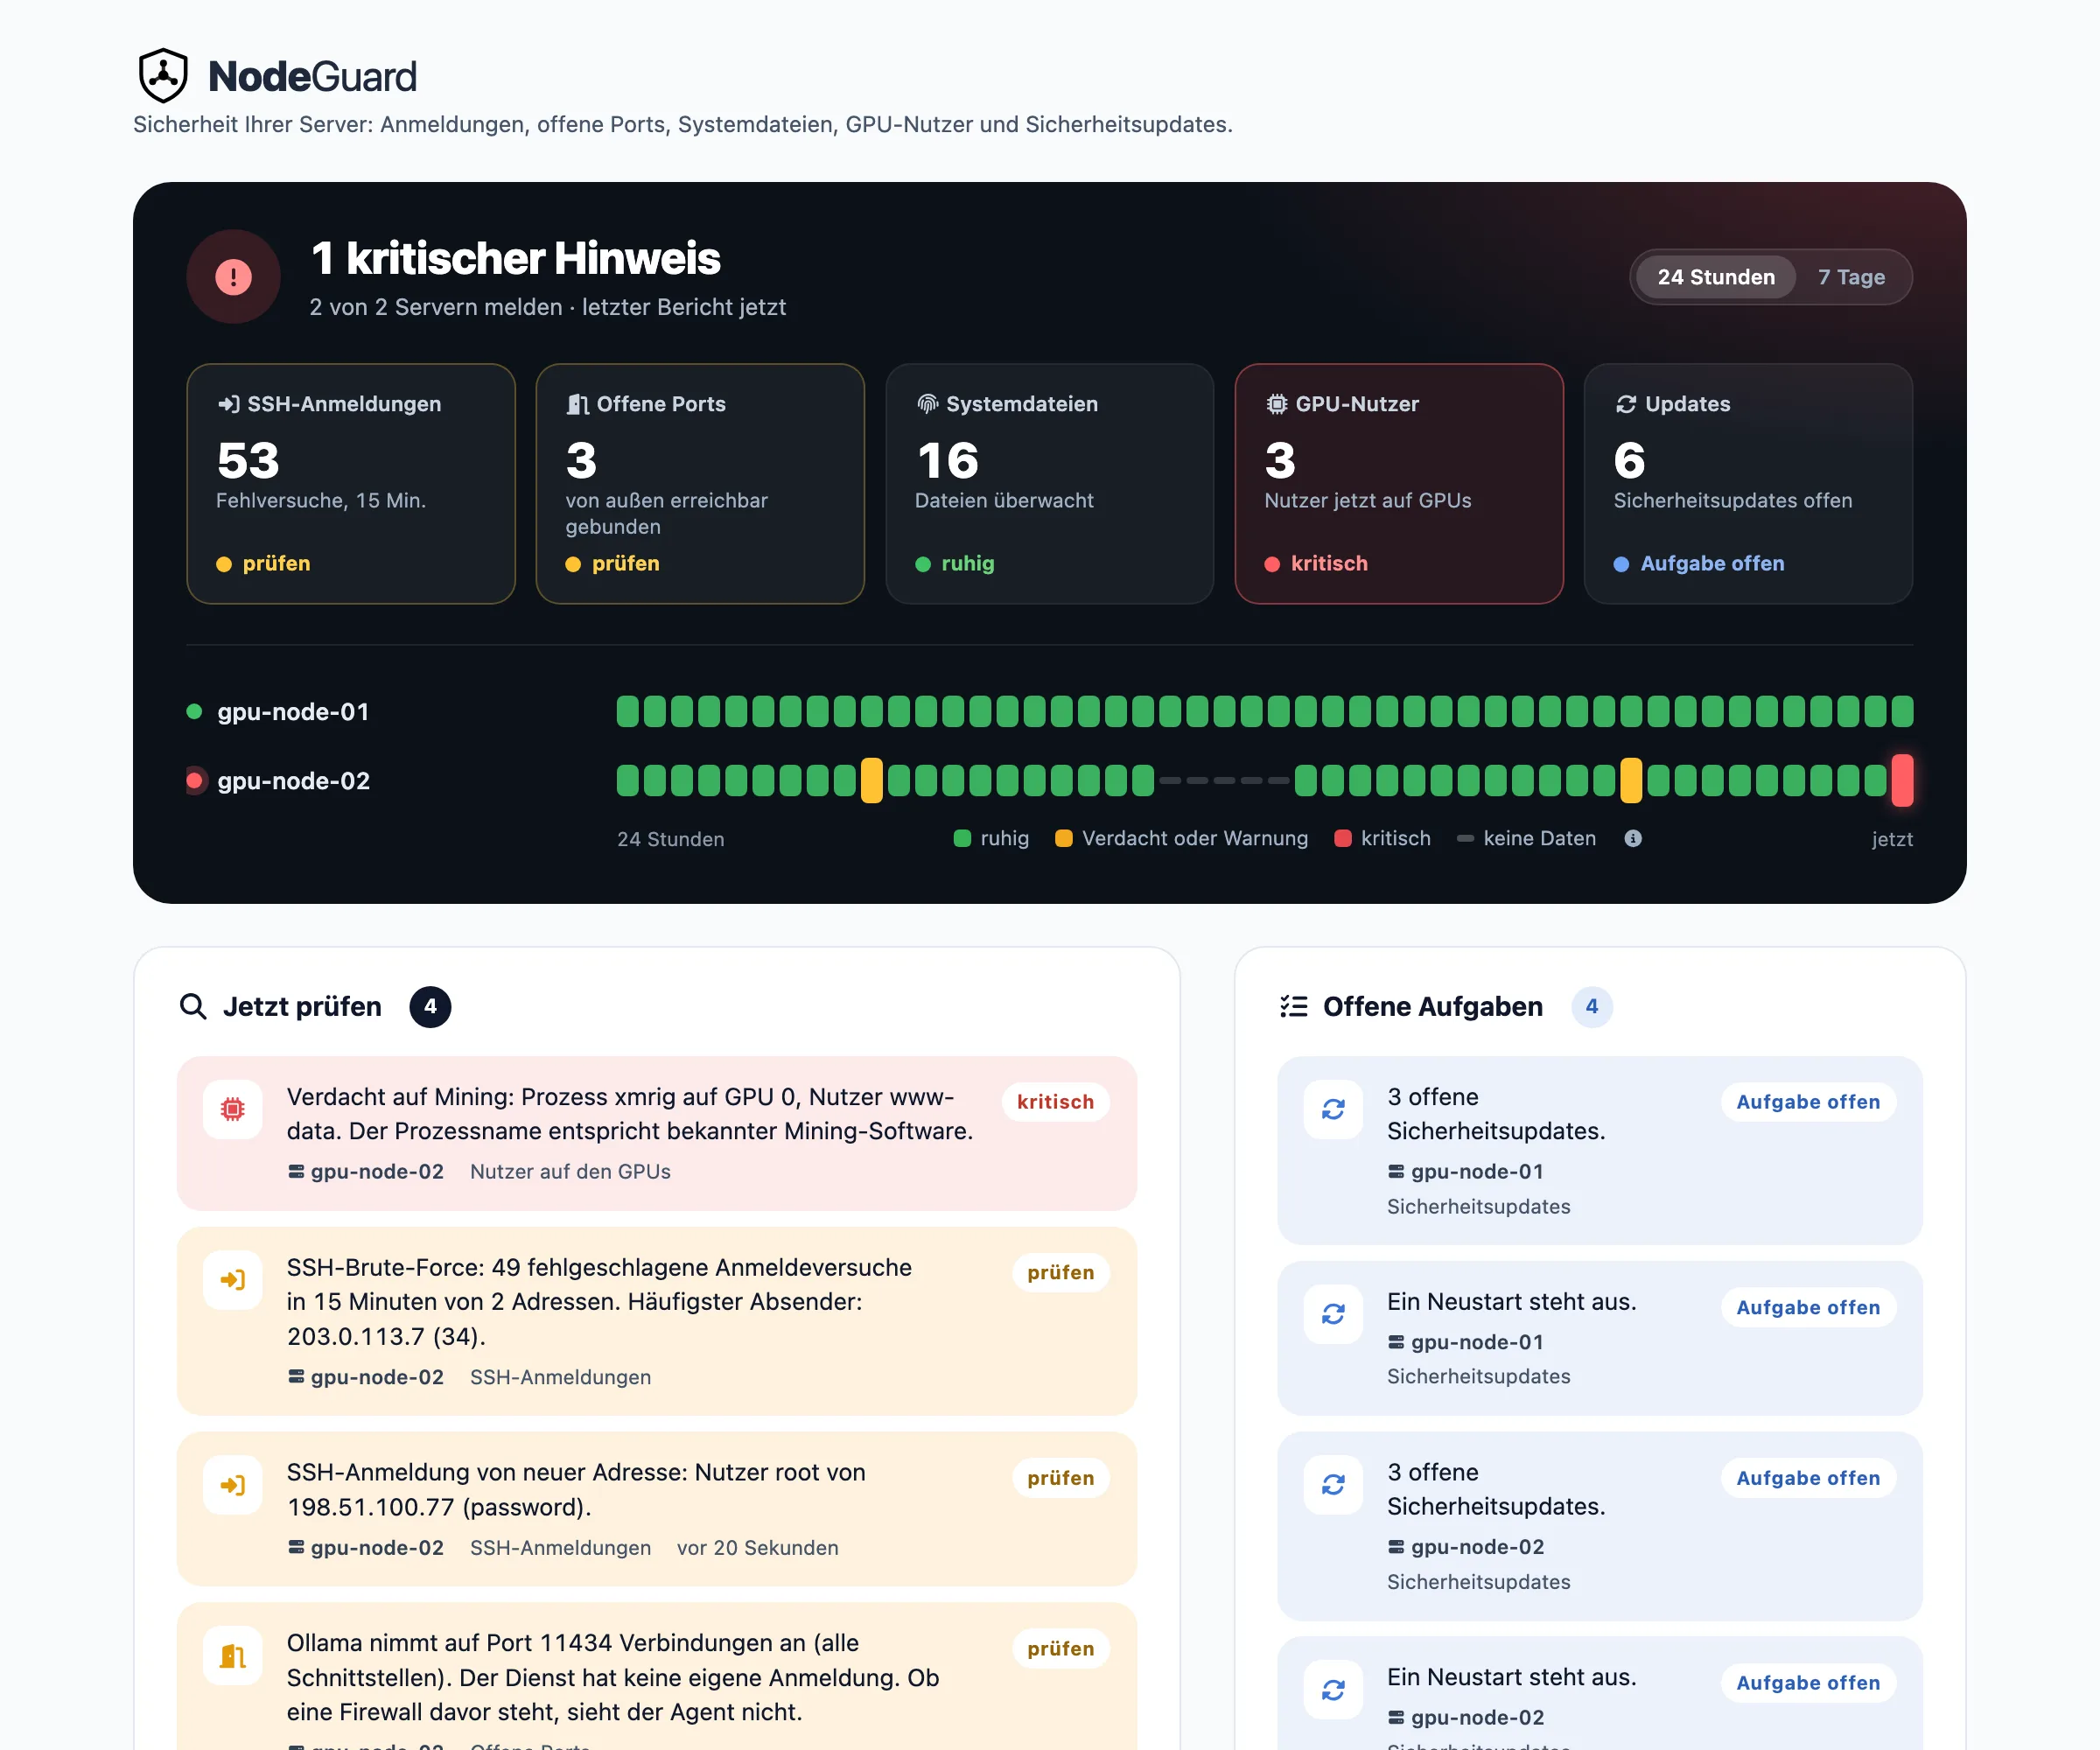
Aufnahme des NodeGuard-Dashboards mit Demo-Daten. Namen und Adressen sind Platzhalter.
NodeGuard mit verhaltensbasierter Anomalieerkennung
Ihre GPU-Server haben einen Tagesrhythmus. NodeGuard lernt ihn je Server und meldet, was nicht hineinpasst, mit Zahlen statt Bauchgefühl.
- Rechenlast, wenn niemand rechnetGPU-Last um drei Uhr nachts auf einer Karte, die sonst leer ist: NodeGuard meldet es, bevor die Stromrechnung es tut.
- Datenabfluss sehenEin Upload, der das Übliche um ein Vielfaches übersteigt, ist eine Warnung, kein Diagramm.
- Keine BlackboxJede Meldung nennt den Wert, den Normalwert und die Uhrzeit. Sie entscheiden, nicht ein Modell.
Lernt 7 Tage, bevor es meldet. Nur Warnung, nie Eingriff. Für GPU-Auslastung, GPU-Leistung, CPU, Upload und Download.
Alarme dort, wo Ihr Team arbeitet
Jeder Monitor hat seine eigenen Kanäle. Ein Ausfall um drei Uhr nachts geht gleichzeitig an Sie, an die Bereitschaft und an die IT des Kunden, als Text mit Link auf den Monitor.
- Je Monitor einstellbarWelche Kanäle ein Monitor benachrichtigt, legen Sie je Monitor fest. Trainingscluster und Inferenz-Server dürfen verschiedene Empfänger haben.
- Mehrere Empfänger gleichzeitigKanäle lassen sich mehrfach anlegen: mehrere Teams-Kanäle, mehrere Adressen, Ihr Ticket-System per Webhook.
- Entwarnung auf demselben WegMeldet der Server wieder Daten, geht die Entwarnung über dieselben Kanäle hinaus.
Offene API
Alle Daten und Einstellungen stehen über eine REST-API bereit.
--url 'https://peaknode.de/api/monitors' \
--header 'Authorization: Bearer {api_key}' \
--header 'Content-Type: multipart/form-data' \
--form 'name=Example' \
--form 'target=https://example.com/' \
Klare Tarife nach Zahl der Server.
Proof of Concept
-
3 Server-Monitore
-
5 Heartbeats
-
5 Uptime-Monitore
-
2 Prüfstandorte
-
5 DNS-Monitore
-
5 überwachte Domains
-
1 Statusseiten
-
Analytics inklusive
-
3 Projekte
-
0 Teams
-
Benachrichtigungskanäle
-
E-Mail-Berichte
-
Vorhaltezeit der Daten: 14 Tage
-
API-Zugang
-
Branding entfernbar
-
Suchmaschinen-Indexierung
-
2 Exportfunktionen
-
Passwortschutz
-
Eigene Adresse für Statusseiten
-
Eigenes CSS
-
Eigenes JavaScript
-
Eigene PWA-App
-
Vorhaltezeit der Statusseiten-Statistiken: 14 Tage
-
Keine Werbung
Premium Lizenz
17% Rabatt-
10 Server-Monitore
-
50 Heartbeats
-
50 Uptime-Monitore
-
2 Prüfstandorte
-
25 DNS-Monitore
-
25 überwachte Domains
-
5 Statusseiten
-
Analytics inklusive
-
Unbegrenzt Projekte
-
1 Teams
-
Benachrichtigungskanäle
-
E-Mail-Berichte
-
Vorhaltezeit der Daten: 1 Jahr
-
API-Zugang
-
Branding entfernbar
-
Suchmaschinen-Indexierung
-
3 Exportfunktionen
-
Passwortschutz
-
Eigene Adresse für Statusseiten
-
Eigenes CSS
-
Eigenes JavaScript
-
Eigene PWA-App
-
Vorhaltezeit der Statusseiten-Statistiken: 1 Jahr
-
Keine Werbung
Enterprise Lizenz
17% Rabatt-
50 Server-Monitore
-
250 Heartbeats
-
250 Uptime-Monitore
-
2 Prüfstandorte
-
100 DNS-Monitore
-
100 überwachte Domains
-
25 Statusseiten
-
Analytics inklusive
-
Unbegrenzt Projekte
-
Unbegrenzt Teams
-
Benachrichtigungskanäle
-
E-Mail-Berichte
-
Vorhaltezeit der Daten: 1 Jahr
-
API-Zugang
-
Branding entfernbar
-
Suchmaschinen-Indexierung
-
3 Exportfunktionen
-
Passwortschutz
-
Eigene Adresse für Statusseiten
-
Eigenes CSS
-
Eigenes JavaScript
-
Eigene PWA-App
-
Vorhaltezeit der Statusseiten-Statistiken: 1 Jahr
-
Keine Werbung
On-Premise
-
Alle Daten bleiben in Ihrem Netz
-
Überwacht interne Systeme und private Netze
-
Keine Grenzen bei Monitoren, GPUs, Nutzern oder Vorhaltezeit
-
Installer, Dokumentation und Einrichtung per Remote-Session
-
Updates als Paket, in einem Schritt eingespielt
-
Lesbarer Quellcode, prüfbarer Agent
Antworten auf häufige Fragen
Ausgehend: Der Server muss Port 443 (HTTPS) zu peaknode.de erreichen. Die Messwerte werden ausschließlich verschlüsselt übertragen.
Jetzt starten
Sehen Sie Auslastung, Zustand und Erreichbarkeit Ihrer GPU-Server an einer Stelle und erfahren Sie von Ausfällen, bevor Ihr Team sie bemerkt.